出典:公益社団法人 日本技術士会「技術士第一次試験 過去問題」
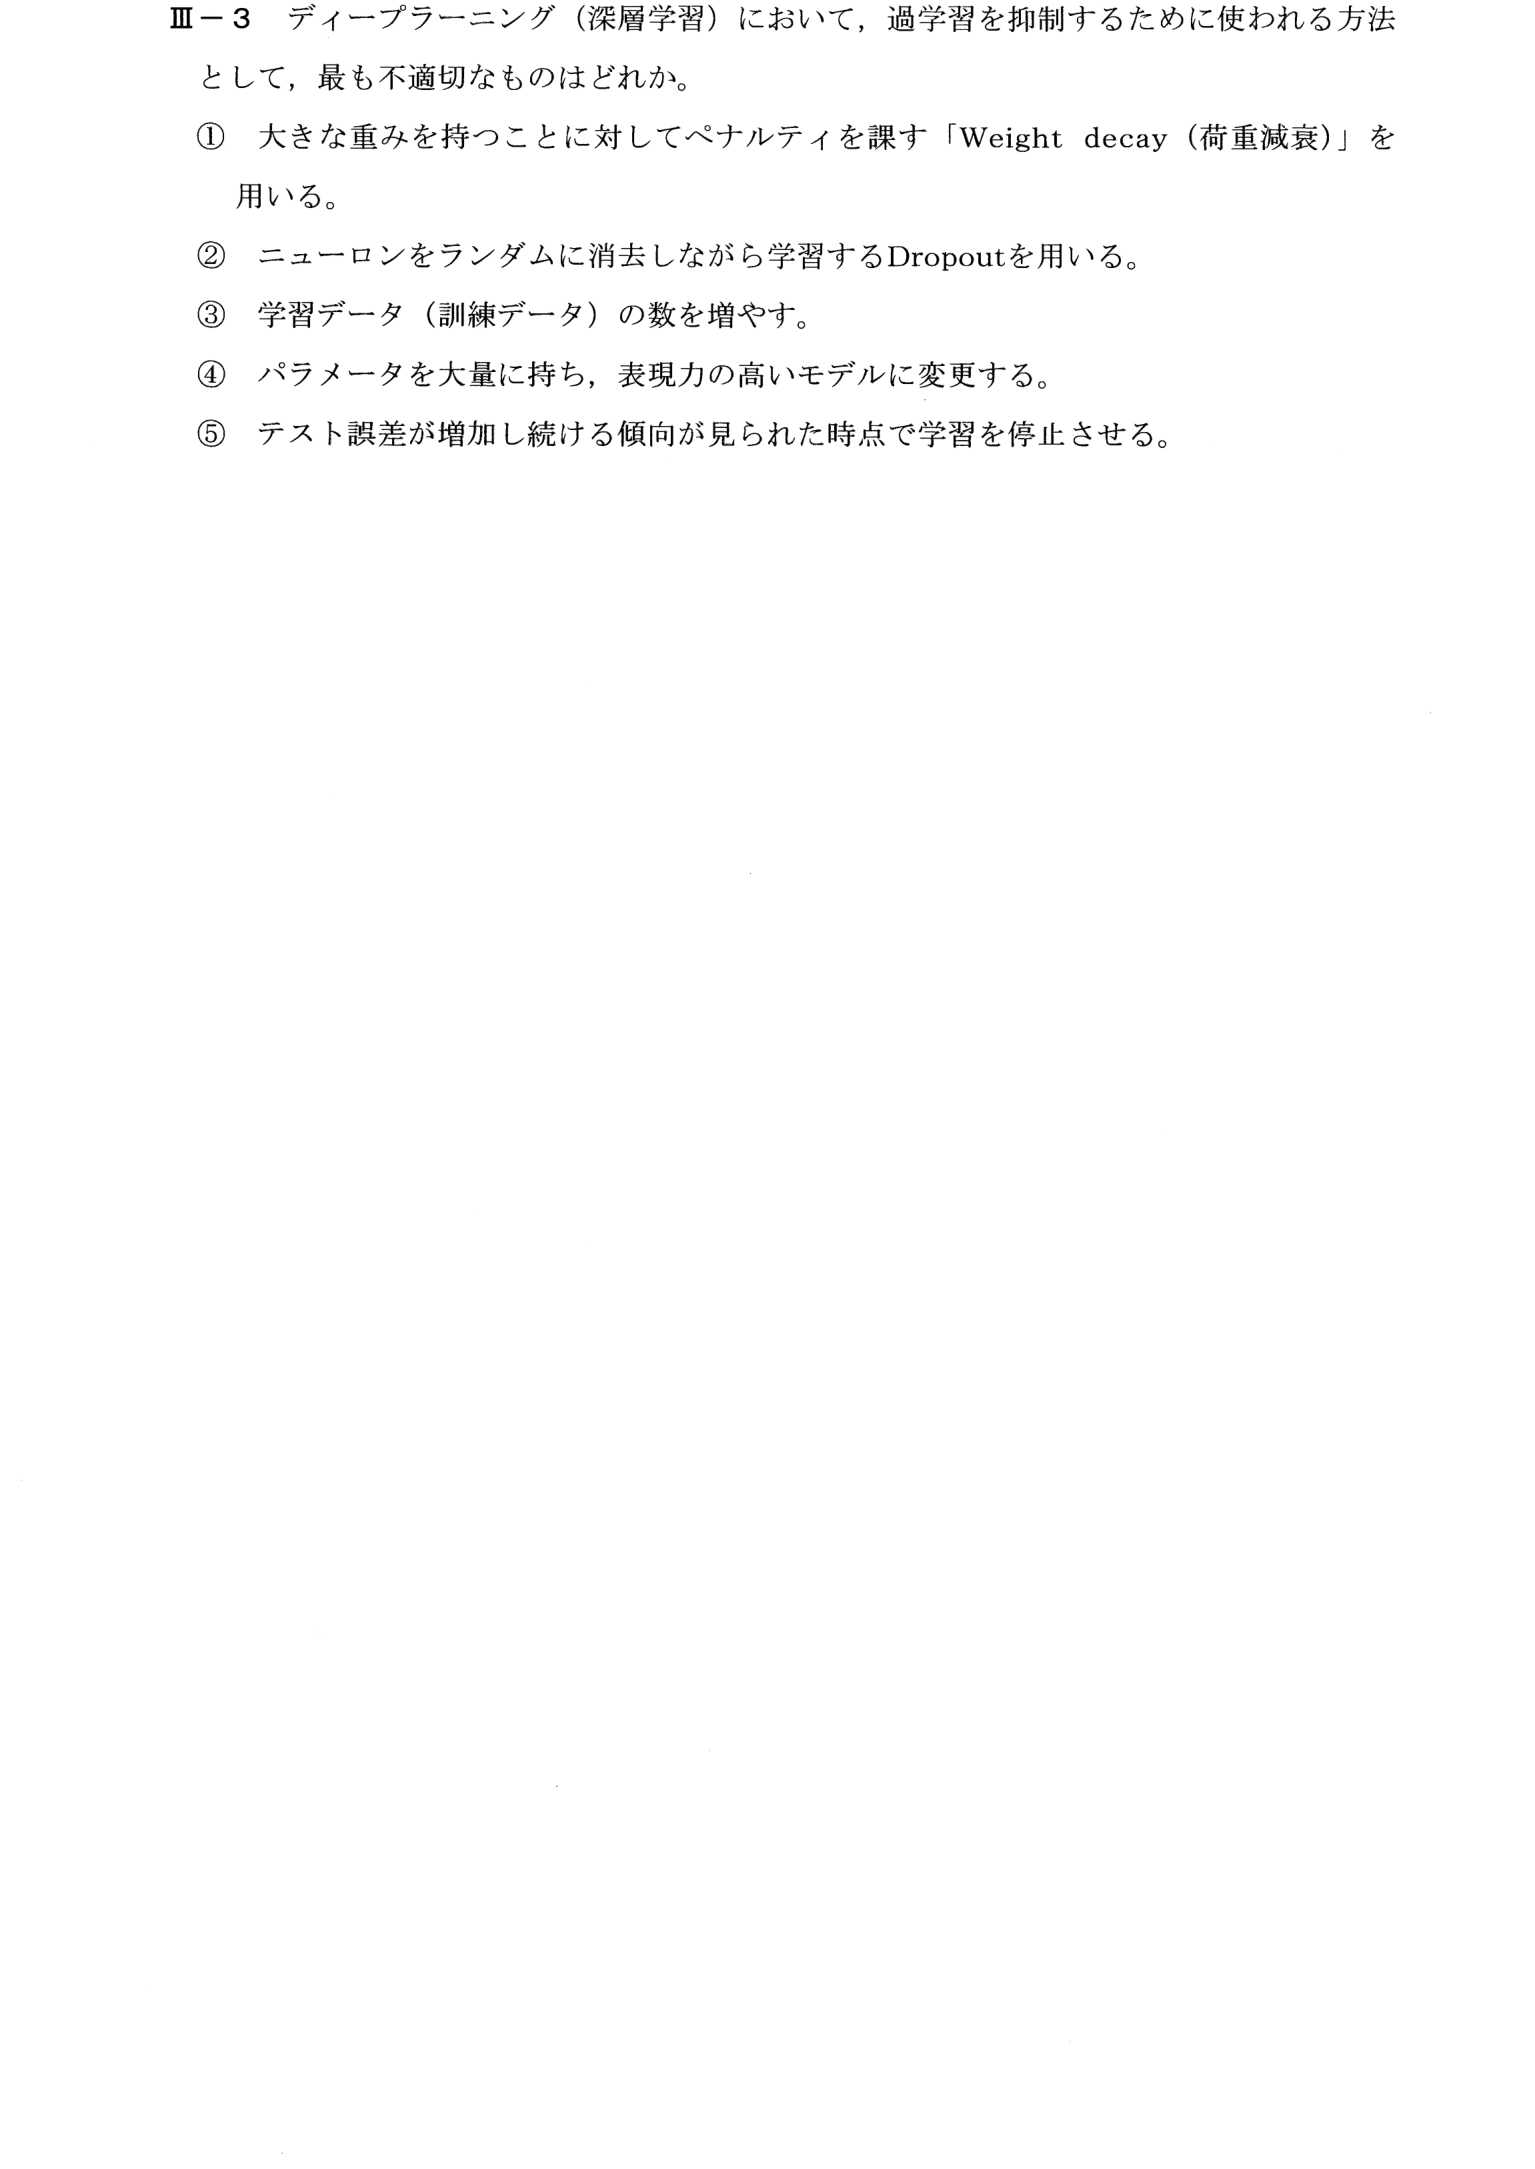
ディープラーニングで過学習を抑制する方法(Weight decay、Dropout、学習データの増加、早期終了)のうち不適切なものを選ぶ問題。
深層学習の過学習を抑える方法として、最も不適切なものを選ぶ問題。
① 過学習=モデルが学習データに合わせすぎる状態。抑える方法: 重みに罰則(Weight decay)、Dropout、データを増やす、早期終了
② ④「パラメータを大量に持ち表現力の高いモデルにする」は、学習データに合わせすぎやすくなり、過学習を招く
③ ④
過学習は、モデルの表現力が学習データに対して高すぎ、学習データに過度に適合してしまう現象である。パラメータを大量に持つ表現力の高いモデルにすると過学習が起こりやすくなるため、④は過学習の抑制方法として不適切。Weight decay、Dropout、学習データの増加、早期終了(テスト誤差が増え始めたら学習を止める)は、いずれも過学習を抑える方法である。したがって④が正答。
過学習の対策は「モデルを単純にする・制約をかける(正則化、Dropout)」「データを増やす」「学習を早めに止める」。モデルを複雑にするのは逆効果。
キーワード: 過学習、ディープラーニング、Dropout、正則化、早期終了、情報工学部門
同じ問題が計2回出題されています(令和元年度、令和4年度)。