出典:公益社団法人 日本技術士会「技術士第一次試験 過去問題」
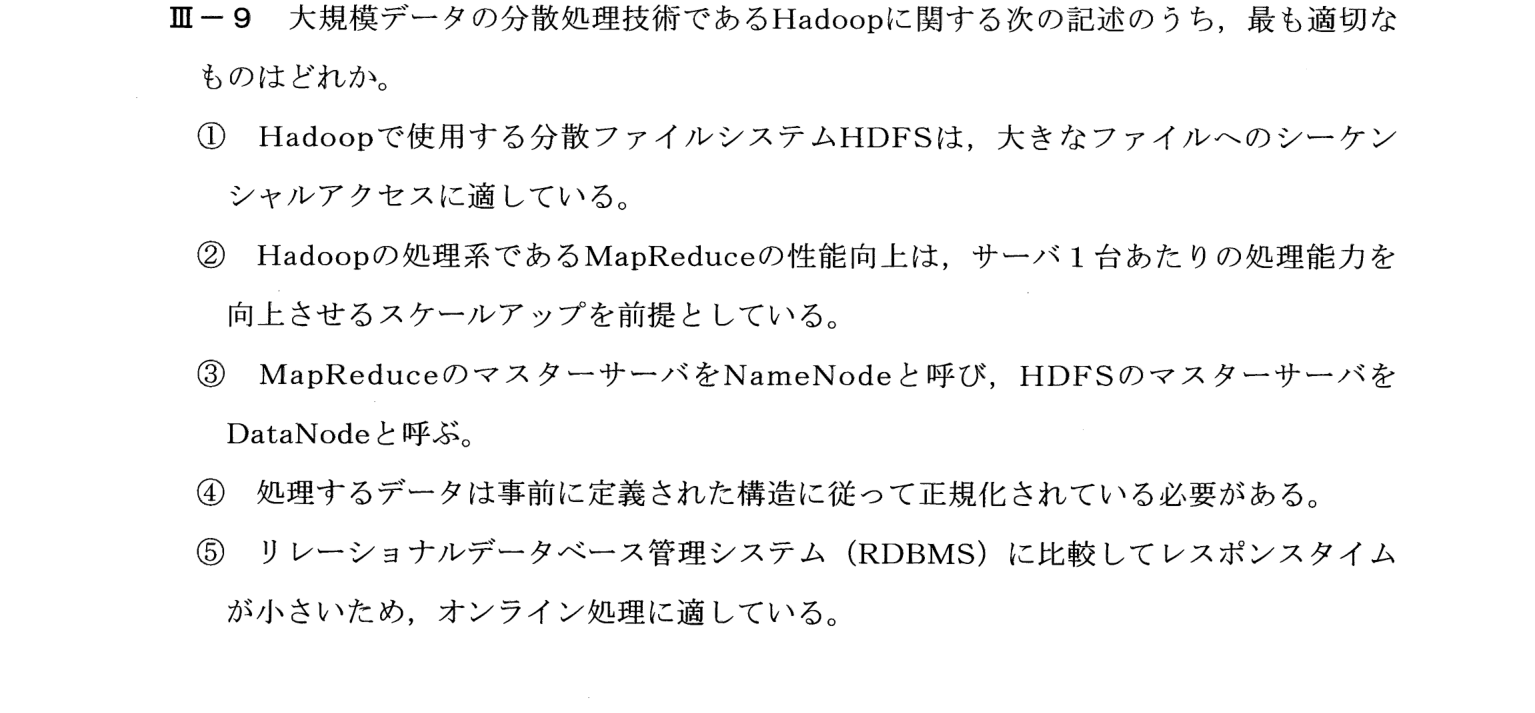
大規模データの分散処理技術Hadoopに関する記述のうち最も適切なものを選ぶ問題。HDFSは大きなファイルへのシーケンシャルアクセスに適しており、スケールアウトを前提とし、バッチ処理向けである。
Hadoopの構成要素と、設計思想(スケールアウト、大きなファイルのバッチ処理)を確認する問題。
① Hadoop=HDFS(大きなファイルを分割して多数のノードに置く)+MapReduce(分散処理)。台数を増やすスケールアウトが前提で、大量データのバッチ処理向き
② ②スケールアップではない、③NameNodeはHDFSのマスター(記述が入れ替わっている)、④構造化していないデータも扱える、⑤応答は遅くオンライン処理には向かない
③ ①
HDFSは、大きなファイルを、ブロックに分割して、多数のノードに分散して格納する分散ファイルシステムで、大きなファイルへのシーケンシャルアクセス(バッチ処理)に適している。したがって①が最も適切である。
Hadoop=HDFS(分散ファイルシステム、NameNode/DataNode)+MapReduce(分散処理)。スケールアウトが前提で、大量データのバッチ処理向け。
キーワード: Hadoop、HDFS、MapReduce、NameNode、DataNode、スケールアウト、バッチ処理、情報工学部門