出典:公益社団法人 日本技術士会「技術士第一次試験 過去問題」
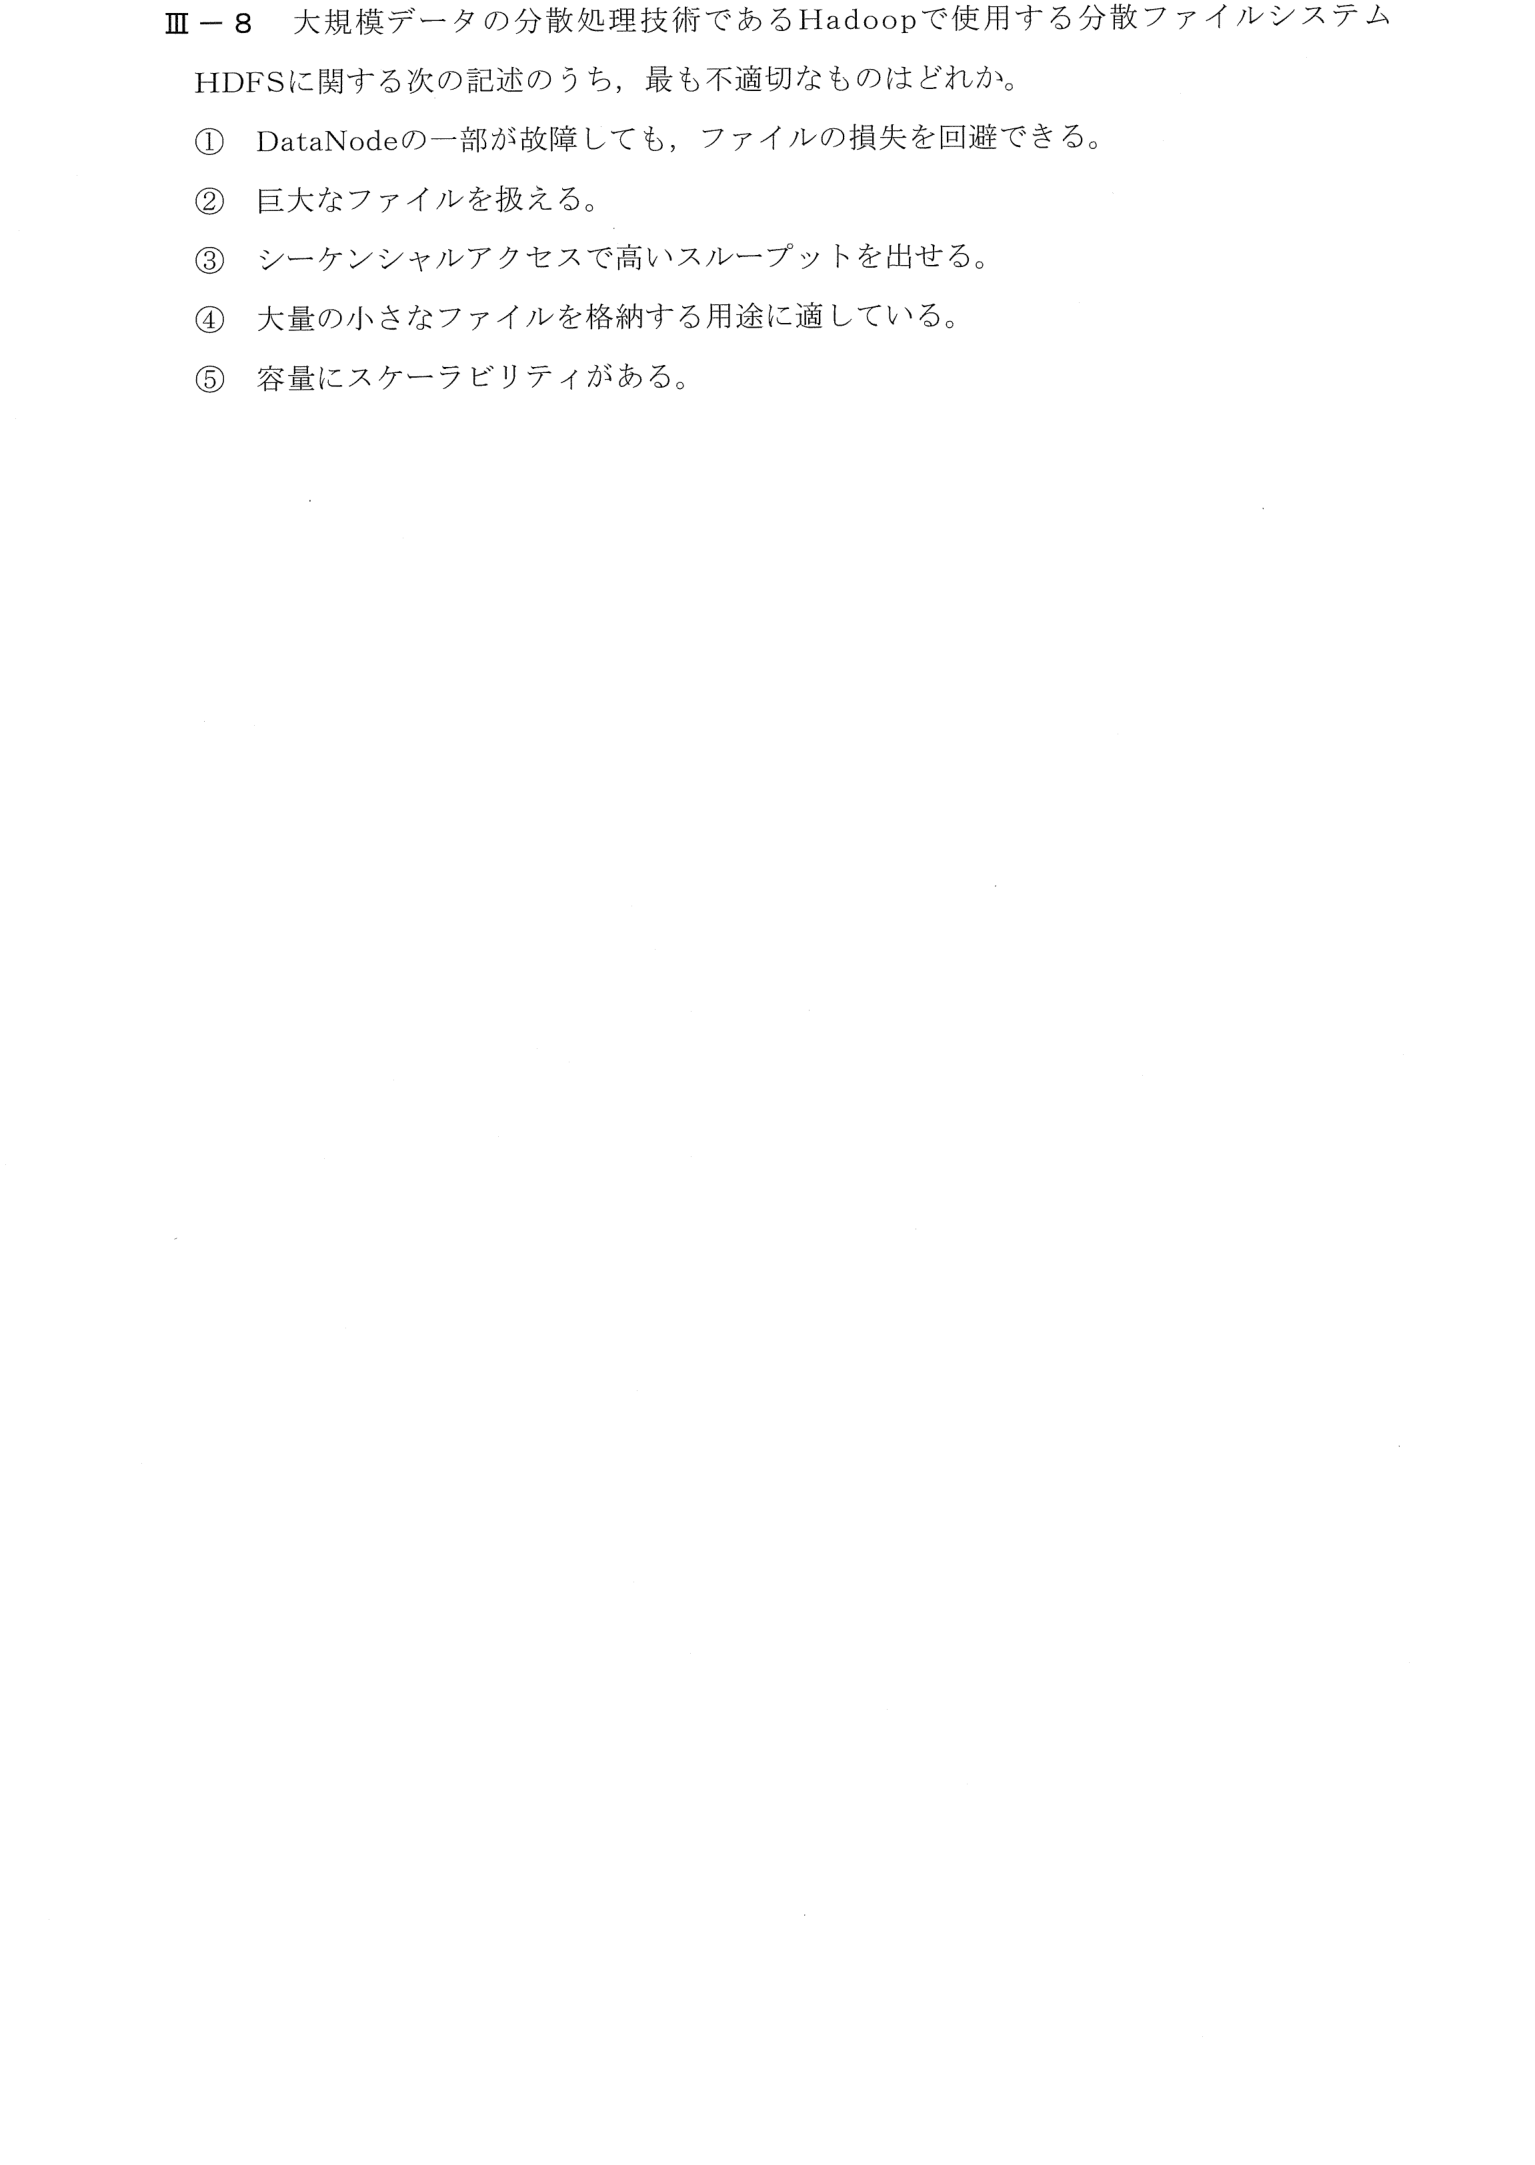
大規模データの分散処理技術Hadoopで使用する分散ファイルシステムHDFSに関する記述のうち、最も不適切なものを選ぶ問題。大量の小さなファイルの格納には向かないことを問う。
HDFSの設計思想(大きなファイルの高スループット処理、複製による耐障害性)を確認する問題。
① HDFS=巨大なファイルをブロックに分けて多数のDataNodeに複製して置く。順番に読む処理に強い。ファイルの管理情報はNameNodeがメモリで持つので、小さなファイルが大量にあると苦手
② ④「大量の小さなファイルに適している」が×
③ ④
HDFSは、巨大なファイルを、ブロック単位に分割して、多数のDataNodeに分散して格納し、シーケンシャルなアクセスで高いスループットを出すように設計されている。ファイルのメタデータは、NameNodeがメモリ上で管理するため、大量の小さなファイルを格納すると、NameNodeのメモリを圧迫して非効率になる。したがって、大量の小さなファイルを格納する用途に適しているとする④が最も不適切である。
HDFSは、大きなファイルのバッチ処理向け。ブロック複製で耐障害性を確保し、NameNodeがメタデータを管理する。小さなファイルの大量格納や低遅延アクセスは苦手。
キーワード: HDFS、Hadoop、分散ファイルシステム、DataNode、NameNode、スケーラビリティ、レプリケーション、情報工学部門