出典:公益社団法人 日本技術士会「技術士第一次試験 過去問題」
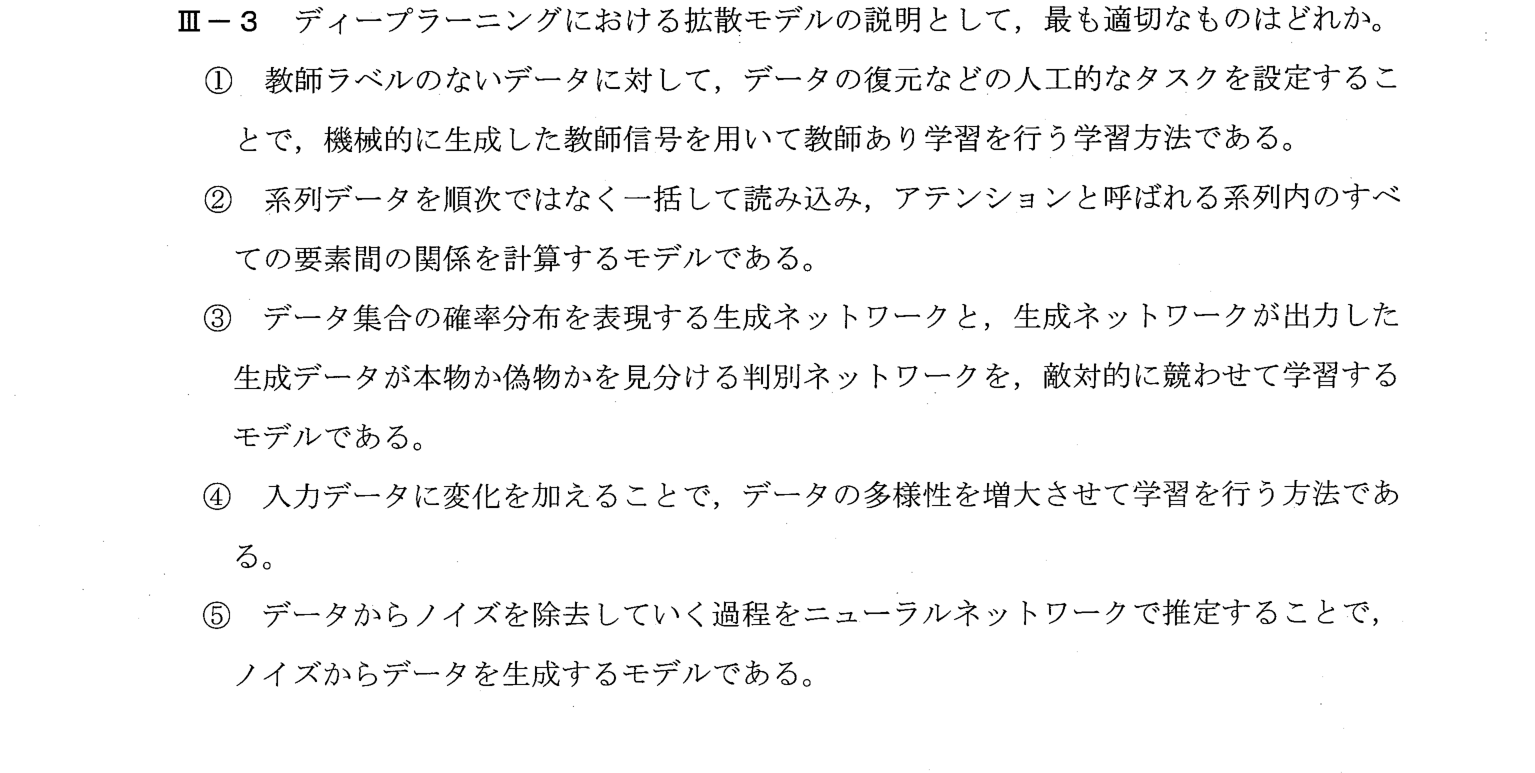
ディープラーニングにおける拡散モデルの説明として最も適切なものを選ぶ問題。自己教師あり学習、Transformer、GAN、データ拡張との違いを識別する。
拡散モデルの特徴を、他の深層学習の手法と区別して選ぶ問題。
① 覚える: 拡散モデル=ノイズを足す過程の逆(ノイズ除去)を学習し、ノイズから生成。GAN=生成と判別を競わせる。Transformer=アテンション。自己教師あり学習=自分で作った教師信号。データ拡張=入力に変化を加える
② ①自己教師あり、②Transformer、③GAN、④データ拡張の説明
③ ⑤
拡散モデルは、データに段階的にノイズを加えていく過程(順過程)と、ノイズを除去してデータを復元する過程(逆過程)を考え、ニューラルネットワークでノイズ除去の過程を推定して学習する生成モデルである。生成時には、ノイズから出発して、学習したノイズ除去を繰り返すことでデータ(画像など)を生成する。したがって⑤が最も適切である。
拡散モデルは、ノイズを加える順過程の逆(ノイズ除去)を学習してデータを生成する生成モデル。GAN(敵対的学習)、Transformer(アテンション)、自己教師あり学習、データ拡張とは区別して押さえる。
キーワード: 拡散モデル、生成モデル、ディープラーニング、GAN、Transformer、ノイズ除去、情報工学部門